1. 图形渲染的本质
1. 成像原理
我们看到物体,是因为光源(太阳、灯泡)发出的光照射到物体上,物体与光发生交互后,一部分光朝向我们的眼睛传播,眼睛把它转换成了视觉信号。
光沿直线传播,可以被物体改变方向和形态。物体与光的交互方式决定了我们所看到的物体的外观:
- 自发光:物体自身发光;
- 吸收:光被物体吸收掉;
- 反射:光在物体表面弹开,粗糙表面产生漫反射,光滑表面产生镜面反射。
图形渲染所研究的问题是:给定一个虚拟三维场景(几何、材质、光源)和一台虚拟相机,计算出成像平面上每个点的颜色。其中:
- 场景中每个点的颜色,并非其本身的颜色。而是沿着光路最终到达相机的所有光的叠加,涉及光照、阴影、多次反射等全局现象
- 成像平面上的每个点在计算机里是离散的像素,这要求连续的光学过程必须被离散化。而离散化又会引入误差,需要采样理论和抗锯齿来解决
2. 图像
把成像平面上的每个位置 对应的光和颜色记为 。一个理想(连续、无限精细)的图像就是这样一个二维函数。渲染的本质,就是计算这个函数在各个位置上的值。
现代显示器由数百万个可独立控制亮度的发光单元组成。每个单元就是一个像素(像素包含红、绿、蓝三个子像素)。
光线是不同波长电磁波的混合。人眼中有三种锥细胞,对红、绿、蓝三段的敏感度不同,任何光谱分布落到人眼中都可以压缩成三个数。
因此显示器只需要用红、绿、蓝三个子像素就可以让视觉合成出相应的色感,而不需要还原真实完整的光谱。渲染器中的颜色通常是三个分量,代表红、绿、蓝三种基色光的亮度贡献:
显示器无法直接处理上文提及的连续二维函数,它只有有限个像素,每个像素只能被赋予一组红、绿、蓝的亮度值。因此,渲染必须先把 离散化:将成像平面划分成 的网格, 每个格子对应一个像素。对第 个像素,通常取它的中心 ,计算 ,更准确的做法是对该像素覆盖的小区域做平均或积分 。这样连续的二维函数 就变成了一个有限的离散像素数组 。
3. 光栅化与光线追踪
现在回到核心问题:对屏幕上的每一个像素,怎样知道达到它的光是什么颜色?
模拟所有光子是物理正确但不可用的,因为计算量过于庞大。所有的实时渲染算法都是本质上都是对光的传输过程做近似。这些方法可以归纳为光线追踪和光栅化两大流派。
1. 光线追踪
光路是可逆的。与其追踪概率极低的从光源出发,最终恰好落进眼睛的光,不如反向追踪:
- 从相机出发,朝每个像素方向投射一条射线,找出它与场景的第一个交点,计算交点处的光照;
- 如果光线在交点处发生镜面反射或折射,就继续递归追踪下去;
- 如果是漫反射则按照材质的 BRDF 进行重要性采样,用蒙特卡洛积分估计间接光照,并可通过俄罗斯轮盘赌等策略适时终止路径。
虽然表述上是朝着画布的像素方向投射射线,但画布本身并无物理实体,不参与任何遮挡关系。像素先于射线存在。
光线追踪与物理过程一一对应。反射,折射,阴影等全局效果天然正确,不用为每种效果使用特例算法。
但每条射线都要在场景中做求交,代价与像素数量和递归深度成正比。传统光线追踪慢到只能离线渲染,虽然现代 GPU 带上了专用的光追单元,但实时渲染中光追依然只是混合渲染的一部分。
当今渲染的主流实践是混合渲染,为保证实时性,光栅化负责主体几何与着色,光追单元负责反射、阴影、全局光照等部分。
2. 光栅化
光线追踪以像素为中心。从画布上的像素出发,向场景发射射线,求出交点。
光栅化以物体为中心。将场景的物体投影到画布上,求出覆盖了哪些像素。
光栅化对每个三角形判定覆盖了哪些像素这一步非常适合硬件并行。但遮挡关系这类全局信息在局部判定中天然缺失,需要额外手段如深度缓冲,阴影贴图等模拟全局效果。
4. 渲染管线
光栅化“把三角形投影到像素网格”这一思路可拆解成一条流水线。
流水线思想与现代工厂一致:把复杂过程划分成若干阶段,每个阶段只做一件小而确定的事,阶段间用数据流连接,再配合并行执行,大幅提高效率。
从逻辑上可划分为应用程序 → 几何 → 光栅化 → 像素处理 四个阶段。
1. 应用程序阶段
这是渲染管线的起点,主要在 CPU 上执行,由应用程序主导,图形 API 作为与 GPU 通信的接口。该阶段决定了当前帧要渲染什么,以及如何准备数据:
- 管理与更新场景数据:维护场景图(如层级关系、空间划分结构)、几何模型(顶点/索引)、材质与纹理、光源以及相机参数,并处理动画、物理模拟或碰撞检测等业务逻辑;
- 执行粗粒度可见性剔除:在 CPU 端进行视锥剔除(Frustum Culling)和潜在的遮挡剔除(Occlusion Culling),快速剔除完全不在相机视野内或被遮挡的物体,从而减少后续需要提交给 GPU 的几何数据量;
- 准备渲染状态与资源:计算物体的模型、视图、投影矩阵;绑定所需的着色器程序、纹理资源和常量缓冲区;设置图元装配和光栅化状态;
- 提交绘制命令:将经过剔除和排序的物体放入渲染队列,通过图形 API 向 GPU 发送绘制调用(Draw Call)。
该阶段最终输出的是包含渲染状态、顶点数据及绘制指令的命令列表,供后续的 GPU 管线(几何处理、光栅化等)消费。
2. 几何阶段
几何阶段主要在 GPU 上执行,其处理的基本对象是顶点数据,每个顶点携带若干属性,如位置、法线、纹理坐标、颜色等。
图元结构决定了以哪种基本的几何表示来进行渲染。一般有:三角形,线段,点。通常使用三角形
该阶段的核心任务是将三维空间中的顶点坐标变换到二维屏幕空间,并将顶点组织成图元,为后续的光栅化做准备。它内部包含以下几个子步骤:
1. 顶点着色器
这是对每个顶点独立执行的一段程序,可编程在 GPU 中并行执行。
顶点之间互相独立,顶点着色器无法访问其他顶点的信息。顶点着色器不能创建或销毁顶点。
主要工作是将顶点从模型空间通过 MVP 矩阵变换到齐次裁剪空间:
-
模型变换:将顶点从各自的局部坐标系转换到统一的世界坐标系
-
观察变换:将顶点从世界坐标系转换到观察坐标系,由虚拟相机的位置与朝向决定
-
投影变换:将顶点从观察空间转换到裁剪空间
视锥体:由上下左右远近六个平面定义。透视投影的视锥体是一个四棱台,近大远小。正交投影的视锥体是一个长方体。
裁剪空间:为了方便计算,投影矩阵结合齐次坐标 将可视范围映射到齐次裁剪空间中。裁剪空间内坐标的 分量的范围都在 之间。透视投影下 通常与观察空间深度相关,用于透视除法;正交投影下 常为 1。
OpenGL 风格为 ,Vulkan/D3D 中 为 。
顶点着色:在顶点着色器中同样可以进行着色计算。这种着色是逐顶点的,随后在光栅化阶段通过插值得到三角形的内部光照。
该方法效果并不理想,因为各片段的着色信息可能非线性变换的,通过插值不能准确反映。此方法称为高洛德着色。不过计算代价低,一个复杂模型可能只有几万个顶点,在顶点着色器中计算光照计算量只有几万次;如果放在片元着色器中就有上百万次。
2. 曲面细分着色器和几何着色器
这两个阶段属于可编程但非必选环节。
曲面细分着色器利用镶嵌化技术对三角面进行细分,以此来增加三角形面数。常用于生成平滑的曲线曲面,以及实现动态细节层次(LOD)。
几何着色器以完整的图元作为输入(如以三角形的三个顶点作为输入)然后输出对应的图元。可以创建或销毁几何图元,亦可根据输入图元类型扩展为其他更多类型的图元。
3. 图元装配
图元装配 (Primitive Assembly) 将顶点数据组装成指定的图元。这一阶段由 GPU 硬件固定管线执行,不可编程。
几何阶段典型的执行顺序:顶点着色器 → (曲面细分着色器) → 图元装配 → (几何着色器) → 裁剪 → 透视除法 → 屏幕映射
4. 裁剪
裁剪发生在投影变换之后,透视除法之前,即在齐次裁剪空间中进行。
完全在裁剪空间内的图元保留;完全在外的舍弃;部分在内的则被切掉空间外的部分,并生成新的顶点。
5. 透视除法
顶点坐标除以 分量,将齐次坐标转化为归一化设备坐标 (NDC)。此时的空间被称为标准视体 (CVV),坐标范围通常在 之间。
OpenGL 中为 ,Vulkan/D3D 中 为 。
6. 屏幕映射
将 NDC 的 从 映射到屏幕像素坐标 和 ( 为屏幕宽高)。
屏幕映射不对 坐标作处理,NDC 中的 值将用于后续的深度测试。
7. 背面剔除
剔除背对摄像机的图元,利用三角形顶点点序来确定正面和背面。OpenGL 默认认为 ccw(counter-clockwise) 是正面,D3D 默认 CW 正面,Vulkan 需要显式配置。
渲染透明或者半透明物体时,使用背面剔除会出现问题。因为此时可以看到物体的背面。
发生在图元装配之后,光栅化之前。而具体阶段没有固定,它会因图形API和硬件实现的不同而有所变化。在 Vulkan 中由光栅化状态配置。
背面剔除是基于图元的朝向(顶点环绕顺序)进行的,因此它必然发生在图元被组装成三角形之后。
3. 光栅化阶段
光栅化阶段接收来自几何阶段的图元数据,将连续的几何图元离散化为屏幕上的片元 (Fragment)。
片元只是像素的候选者。它包含了颜色、深度以及纹理坐标等插值后的数据,只有通过了后续的各项测试,才会真正成为屏幕上的像素。
过程会遍历三角形,寻找三角形所覆盖的所有像素中心点,对覆盖的像素,利用三角形的顶点信息进行插值,生成该像素对应的片元数据。遍历完成后,输出一个片元序列。由于物体重叠,同一屏幕像素位置可能会生成多个来自不同三角形的片元。
例如一个三角形覆盖了 10 个像素中心,就生成约 10 个片元。每个片元携带在屏幕上对应的二维坐标,深度,三角形顶点属性在该位置插值后的结果等。
通常来说片元的数量大大多于原始顶点数,且高分辨率、overdraw 严重时会更多,所以高洛德着色通常更廉价。但并非绝对,低分辨率、高模、小三角形、大量实例化时,顶点数量也可能会更多。
4. 像素处理阶段
接收来自光栅化阶段的片元序列,最终决定屏幕每个像素的颜色。通常包括片元着色器、测试与混合。
片元着色器
接收插值后的片元数据,逐片元计算最终着色(如纹理采样、光照计算、阴影等)。片元之间互不影响,可高效并行执行。
测试与混合
测试:包括深度测试(判断片元是否被前方物体遮挡)、模板测试(控制渲染区域)、Alpha 测试(透明度丢弃)等。未通过测试的片元将被直接丢弃。
混合 :通过的片元,如果是半透明的,会将其颜色与帧缓存中已有的像素颜色按一定规则进行混合;如果是不透明的,则直接覆盖。
完成所有处理后,颜色值写入帧缓存,最终显示在屏幕上。
5. GPU 与可编程管线
1. 固定管线
图形硬件最初以固定功能管线实现渲染:顶点变换,光照等计算由专用硬件逻辑执行,开发者只能调整矩阵、光源、材质等参数,表达范围受限。
2001年 GeForce 3 首次引入可编程顶点着色器,随后数年可编程着色器逐步支持流控制和高级语言的通用编程性。当今,渲染管线中的顶点处理、像素着色等已经完全可编程;而裁剪、三角形设置与遍历、屏幕映射,以及深度、模板测试、混合等难以程序化的操作仍由固定功能或可配置的专用硬件执行。
2. SIMT
GPU 有数千个小型运算核心,并行度极高但每个核心的能力如分支预测、乱序执行等被大幅简化。
GPU 的执行模型为 SIMT(单指令多线程)。GPU 以 warp (NVIDIA, 32 线程) 或 wavefront/wave (AMD, 通常 32 或 64 线程) 为单位调度执行。
一个 warp 内的所有线程共享同一个程序计数器和取指/译码单元,在同一时刻只能执行同一条指令。所以当一个 warp 内部发生 if else 分歧时,如果两条路径都要执行,那么分歧路径会被串行地各执行一遍,每次只有对应的部分线程真正生效,其余线程空转。执行时间逻辑上是两条路径耗时之和,而非 CPU 中的 max。
尽管 2017 年后 Volta 架构引入了独立线程调度(ITS),if 和 else 可以交错执行,而不必严格串行。但无法让不同线程同一时刻执行不同指令这一根本限制没有改变,执行资源仍然按 warp 粒度分配,分歧路径降低效率。
因此,在图形着色器中需要注意以下原则:
- 顶点、片元之间互相独立。着色器不能访问邻接顶点的数据,邻接信息要么提前烘焙进属性,要么放在 texture 中读取
- 分支昂贵。shader 优化中,常见手段就是减少分支、把分支改成无分支的算术(如 mix/step/掩码乘法),或让相邻数据尽量走同一路径。
- 注意数据规整。连续线程访问连续内存时,显存带宽利用率最高。
6. 图形 API
图形 API 是一套预定义的函数、数据结构、协议和工具的集合。它是连接应用程序和图形硬件的桥梁。
图形 API 规定了应用程序如何向 GPU 发出命令,以及 GPU 需要提供哪些功能。基于这份相同的协议, GPU 制造商和应用程序的开发者开发的产品就能兼容。如果没有图形 API,那么意味着开发者不得不为每一款特定的 GPU 编写机器码,成本巨大。
1. 演进
1. 固定功能 API:渲染管线功能固定,开发者者只能通过 API 调整一些预设参数,但无法改变 GPU 实际执行的计算。如 OpenGL 1.x / Direct3D 7 (1993 - 2001)。
**2.隐式管理 API **:着色器可编程,开发者可以自定义出复杂的渲染效果。驱动负责分配内存、管理状态、翻译指令、校验错误、同步等诸多职责。这种隐式设计虽然让开发者使用简单,但使得驱动需要猜测应用意图,且只能进行单线程提交,应用侧难以充分利用多核。如 OpenGL 2-4 / D3D9 - 11 (2001 - 2015)。
3. 显式控制 API:将内存管理、多线程同步等责任交还给开发者,从而换取更低的 CPU 开销、更可预测的性能和更好的多核利用效果。如 DirectX12(2015), Vulkan (2016)。
2. Vulkan 的显式控制
Vulkan 的显式控制和更老的图形 API 对比主要体现在以下层面:
-
内存管理:从自动分配到手动绑定
在 OpenGL 中,创建一个纹理,驱动会为其自动分配显存,开发者无需关心细节;
在 Vulkan 中,首先需要查询设备支持的内存类型,如仅 GPU 可见的
DEVICE_LOCAL或 CPU 可见的HOST_VISIBLE,然后显式分配一大块原生内存。之后,还需要将这块内存显式地绑定到图像或者缓冲区上。这样的显式控制让开发者能够精确控制内存布局,实现内存别名(Aliasing)等高级优化,降低内存占用。
-
同步机制:从隐式处理到手动同步
OpenGL 会自动处理资源间的读写依赖,保证命令按正确顺序执行。
在 Vulkan 中,同步主要是应用程序的责任,因为命令在 GPU 上的执行顺序默认是未定义的。Vulkan 中提供五种显式同步原语使得开发者能够精确控制:
- Fences(栅栏):用于 CPU 与 GPU 之间的同步,让 CPU 等待 GPU 完成工作;
- Semaphores(信号量):用于多个 GPU 队列之间的同步,控制不同队列的访问顺序;
- Events(事件):提供细粒度的同步,可在命令缓冲内外发出信号或等待,用于单个队列内的控制;
- Pipeline Barriers(管线屏障):在命令缓冲内部的特定点进行同步,主要用于控制同一队列内资源的读写依赖和图像布局转换;
- Render Pass Objects(渲染通道对象):提供内置的同步框架,可以更高效地表达附件(如颜色、深度缓冲)的依赖关系。
-
状态管理:从动态修改到静态管线对象
OpenGL 是一个巨大的状态机。可以随时修改混合、深度测试等状态,驱动会为此付出状态切换的开销。
Vulkan 则采用静态管线对象的概念。在创建管线时,一次性、完整地指定所有渲染状态(着色器、顶点格式、混合模式等),之后这个管线对象就是不可变的。要改变状态,必须创建一个新的管线对象。虽然增加了前期的工作,但避免了运行时的状态切换开销,性能更可预测。
-
命令提交:从即时执行到预录制与提交
OpenGL 的 API 调用(如
glDrawArrays)会直接触发绘制,驱动在后台管理命令流。Vulkan 则采用预录制、后提交的模式,所有的绘制、内存传输等命令,都需要显式地录制到一个命令缓冲区中;录制完成后,需要在合适的时机将这个命令缓冲区显式地提交到一个队列,等待 GPU 执行。
这种模式原生支持多线程,可以让多个线程并行地录制不同的命令缓冲区,从而充分利用多核 CPU。
-
渲染通道与帧缓冲:显式定义与绑定
在 OpenGL 中,可以直接将纹理附加到帧缓冲,其布局转换由驱动隐式管理。
Vulkan 则要求先定义一个渲染通道,用它来声明本次渲染使用哪些附件、加载与存储行为以及子通道的依赖关系。然后创建帧缓冲对象。并将具体的图像视图显式地绑定到渲染通道定义的附件槽位上。
3. Vulkan 对象模型
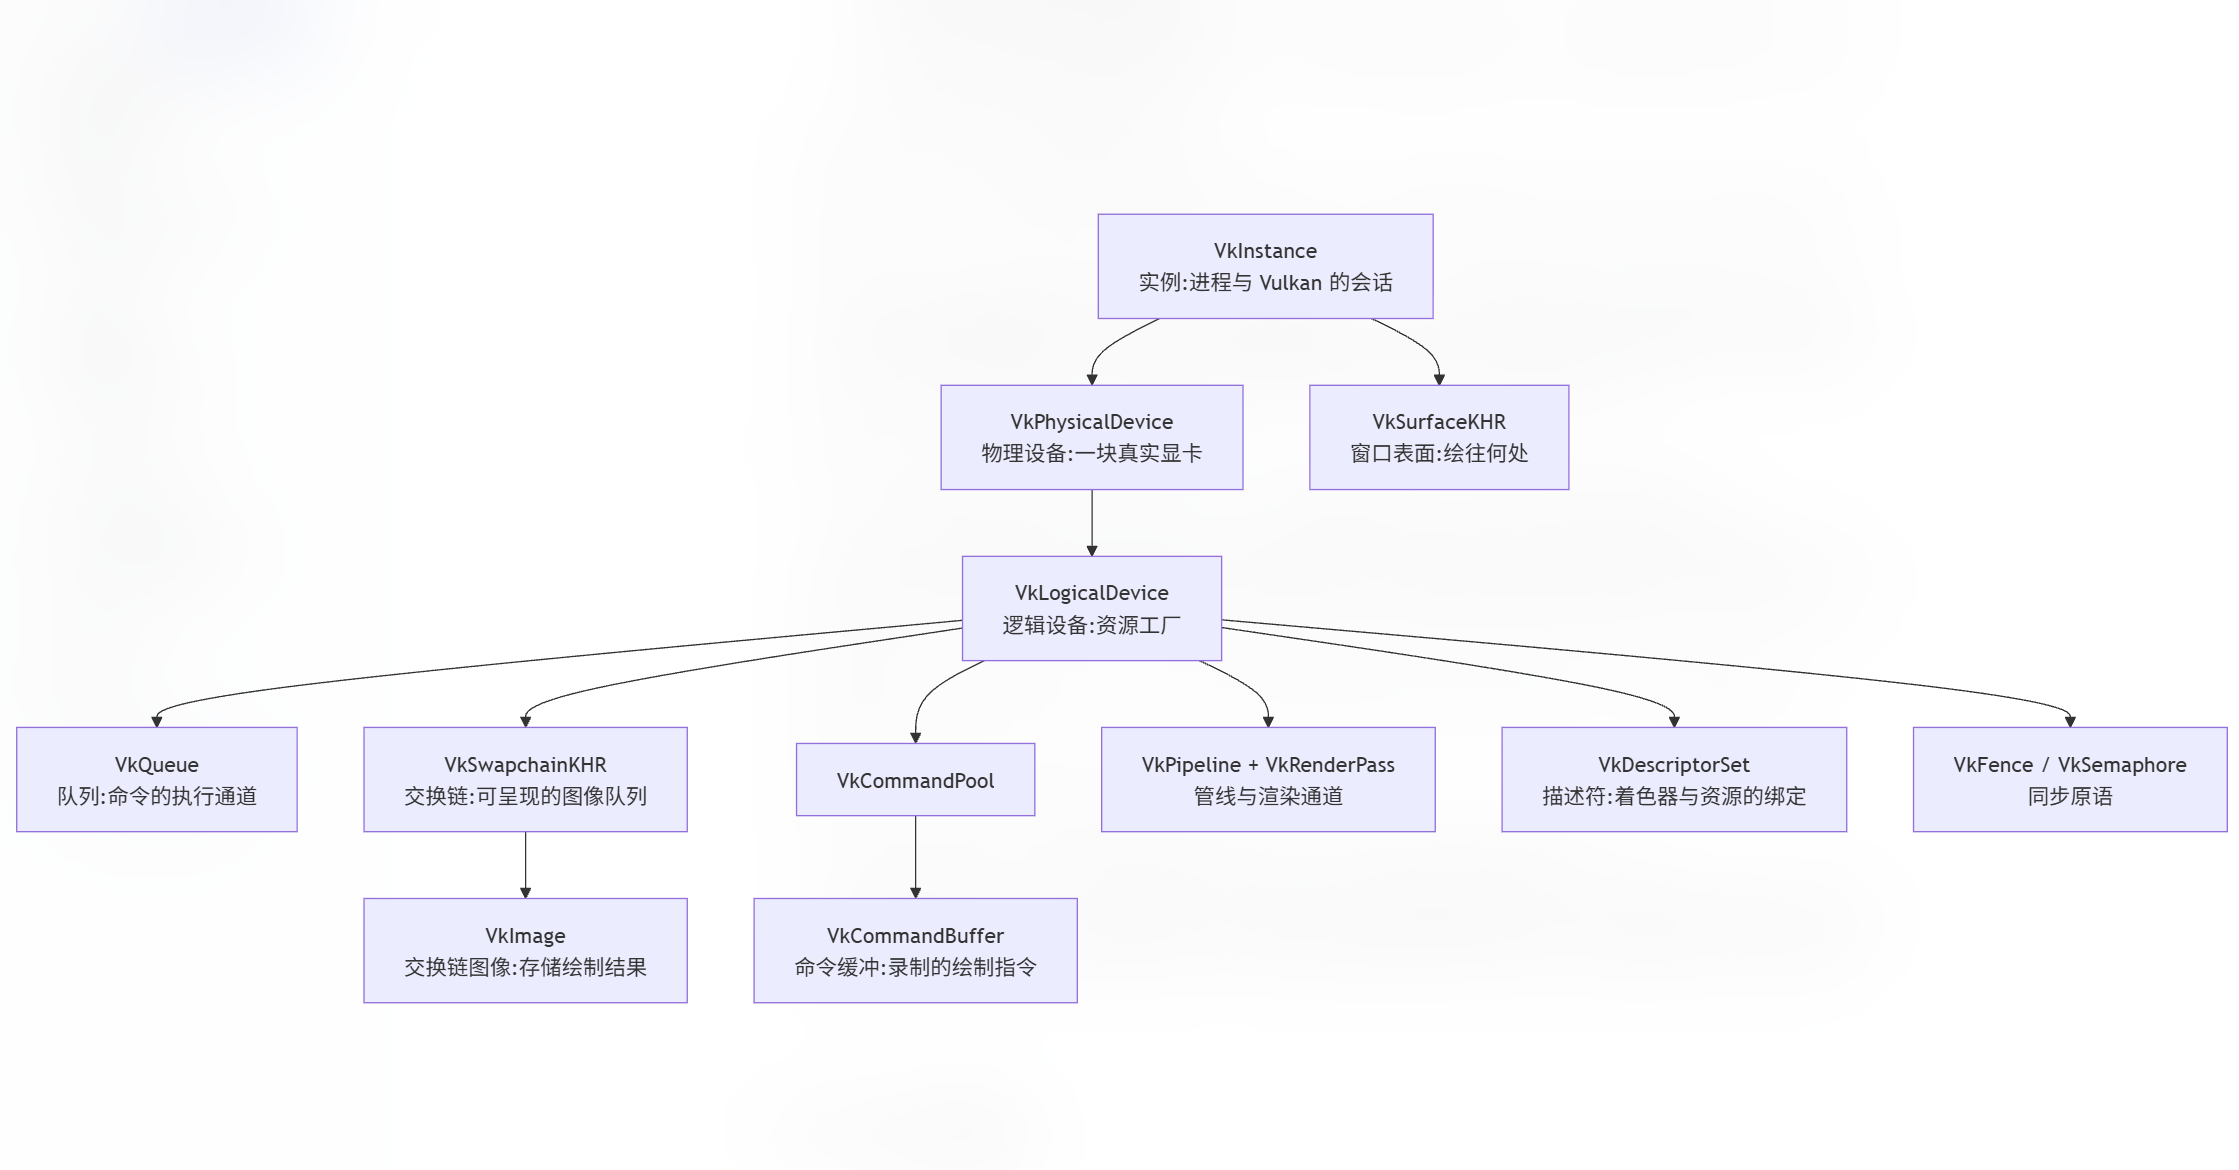
VkInstance 进程级唯一,代表应用与 Vulkan 建立的会话。
Vulkan 中所有对象都有明确的生命周期归属关系,父对象销毁前必须先销毁子对象。
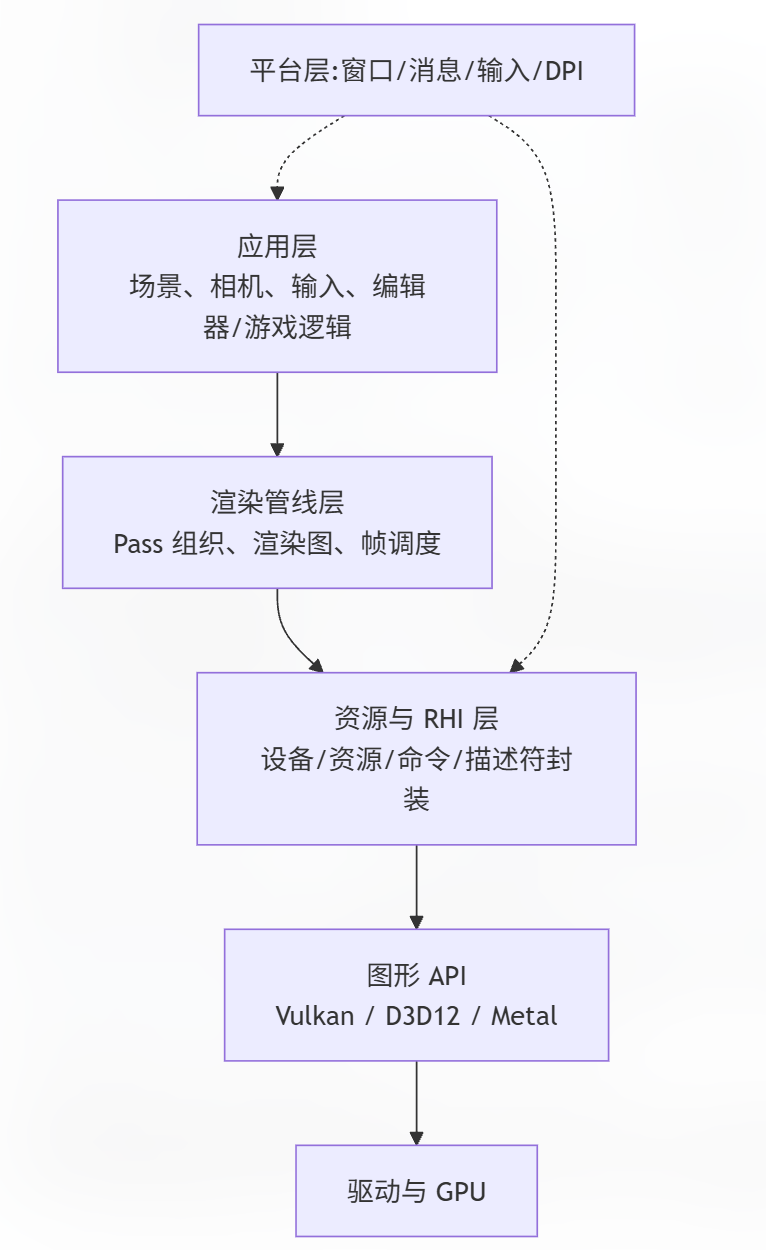
7. 现代渲染引擎架构分层
一个典型的引擎分层: